Domain xmsj.de kaufen?
Wir ziehen mit dem Projekt
xmsj.de um.
Sind Sie am Kauf der Domain
xmsj.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain xmsj.de kaufen?
Gibt es Suchmaschinen, deren Webcrawler die robots.txt ignorieren?
Ja, es gibt Suchmaschinen, deren Webcrawler die robots.txt ignorieren. Ein Beispiel dafür ist beispielsweise die Suchmaschine "Yandex". Dies kann dazu führen, dass Inhalte, die in der robots.txt-Datei als nicht zugänglich markiert sind, dennoch von diesen Suchmaschinen indexiert werden. **
Was ist ein Webcrawler und wie funktioniert er?
Ein Webcrawler ist ein Computerprogramm, das automatisch das Internet durchsucht, um Informationen zu sammeln. Er funktioniert, indem er eine Liste von URLs abruft, die er dann besucht und den Inhalt indexiert. Der Webcrawler folgt dabei Links auf den besuchten Seiten, um weitere Informationen zu sammeln. **

Ähnliche Suchbegriffe für Webcrawler
Top-Angebote
Produkte zum Begriff Webcrawler:
-
Mobilis U.FIX Handy/Smartphone Passive Halterung Auto Schwarz Zubehör Telefone (044018)Produktbeschreibung: Mobilis U.FIX Mini Mount - Halterung für Kfz für Handy, Produkttyp: Halterung für Kfz, Bestimmt für: Handy, Geeignet für Installation: Auto, Farbe: Schwarz18,89 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter

-
Wie funktionieren Webcrawler und wie werden sie zur Indexierung von Websites eingesetzt?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Websites folgen. Sie sammeln Informationen über Websites und speichern sie in einer Datenbank. Diese gesammelten Informationen werden dann von Suchmaschinen verwendet, um die Websites zu indexieren und in den Suchergebnissen anzuzeigen. **
-
Wie funktionieren Webcrawler und welche Rolle spielen sie beim Indizieren von Websites?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Websites folgen und deren Inhalte indexieren. Sie scannen Websites nach relevanten Keywords und Meta-Tags, um sie in Suchmaschinen-Datenbanken zu speichern. Dadurch ermöglichen sie Suchmaschinen, relevante Websites für bestimmte Suchanfragen zu finden und anzuzeigen. **
-
Wie kann ich mit Python und BeautifulSoup einen Webcrawler für Websites erstellen?
Um einen Webcrawler mit Python und BeautifulSoup zu erstellen, musst du zunächst die BeautifulSoup-Bibliothek installieren. Dann kannst du eine HTTP-Anfrage an die gewünschte Website senden und den HTML-Code der Seite mit BeautifulSoup analysieren. Du kannst dann bestimmte Elemente oder Informationen aus dem HTML-Code extrahieren und weiterverarbeiten. **
-
Welche Faktoren beeinflussen die Geschwindigkeit, mit der Webcrawler eine Website durchsuchen können?
Die Geschwindigkeit, mit der Webcrawler eine Website durchsuchen können, wird von der Serverleistung der Website, der Größe der Website und der Anzahl der Links auf der Website beeinflusst. Außerdem spielen die Netzwerkgeschwindigkeit und die Einstellungen des Webcrawlers eine Rolle bei der Durchsuchungsgeschwindigkeit. Eine gut optimierte Website mit schnellem Server und wenigen Links kann die Geschwindigkeit der Webcrawler erhöhen. **

Wie funktionieren Webcrawler und welche Rolle spielen sie bei der Indexierung von Webinhalten?
Webcrawler sind Programme, die automatisch das Internet durchsuchen und Webseiten indexieren. Sie folgen Links von einer Seite zur nächsten, um relevante Informationen zu sammeln. Dadurch helfen sie Suchmaschinen, Webinhalte zu finden und zu organisieren, um sie den Nutzern bei Suchanfragen präsentieren zu können. **
Wie funktionieren Webcrawler und was ist ihre Rolle bei der Indexierung von Websites?
Webcrawler sind Programme, die automatisch das Internet durchsuchen, indem sie Links auf Websites verfolgen und deren Inhalte analysieren. Sie sammeln Informationen über Webseiten, wie Texte, Bilder und Links, um sie in Suchmaschinenindexen zu speichern. Dadurch ermöglichen sie Suchmaschinen, relevante Suchergebnisse für Benutzer bereitzustellen. **
Top-Angebote
Produkte zum Begriff Webcrawler:
-
Gibt es Suchmaschinen, deren Webcrawler die robots.txt ignorieren?
Ja, es gibt Suchmaschinen, deren Webcrawler die robots.txt ignorieren. Ein Beispiel dafür ist beispielsweise die Suchmaschine "Yandex". Dies kann dazu führen, dass Inhalte, die in der robots.txt-Datei als nicht zugänglich markiert sind, dennoch von diesen Suchmaschinen indexiert werden. **
-
Was ist ein Webcrawler und wie funktioniert er?
Ein Webcrawler ist ein Computerprogramm, das automatisch das Internet durchsucht, um Informationen zu sammeln. Er funktioniert, indem er eine Liste von URLs abruft, die er dann besucht und den Inhalt indexiert. Der Webcrawler folgt dabei Links auf den besuchten Seiten, um weitere Informationen zu sammeln. **
-
Wie funktionieren Webcrawler und wie werden sie zur Indexierung von Websites eingesetzt?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Websites folgen. Sie sammeln Informationen über Websites und speichern sie in einer Datenbank. Diese gesammelten Informationen werden dann von Suchmaschinen verwendet, um die Websites zu indexieren und in den Suchergebnissen anzuzeigen. **
-
Wie funktionieren Webcrawler und welche Rolle spielen sie beim Indizieren von Websites?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Websites folgen und deren Inhalte indexieren. Sie scannen Websites nach relevanten Keywords und Meta-Tags, um sie in Suchmaschinen-Datenbanken zu speichern. Dadurch ermöglichen sie Suchmaschinen, relevante Websites für bestimmte Suchanfragen zu finden und anzuzeigen. **
Ähnliche Suchbegriffe für Webcrawler
-
Mobilis U.FIX Handy/Smartphone Passive Halterung Auto Schwarz Zubehör Telefone (044018)Produktbeschreibung: Mobilis U.FIX Mini Mount - Halterung für Kfz für Handy, Produkttyp: Halterung für Kfz, Bestimmt für: Handy, Geeignet für Installation: Auto, Farbe: Schwarz18,89 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
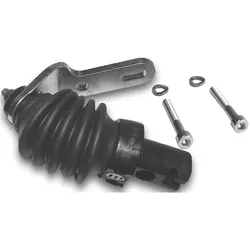
Weber Technik, Veloanhänger ZubehörDie ER-Kupplung von Weber Technik ist ein spezialisiertes Zubehör für Veloanhänger, das eine sichere und zuverlässige Verbindung zwischen dem Anhänger und dem Rohloff-Ausfallende ermöglicht. Diese Kupplung ist für die Montage an verschiebbaren Rohloff-Ausfallenden konzipiert und bietet eine Tragfähigkeit von bis zu 80 kg. Sie wird mit zwei NIRO-Schrauben und zwei Nord-Lock-Scheiben geliefert, die eine einfache und stabile Installation gewährleisten. Die ER-Kupplung ist aus einer Kombination von Kunststoff und Stahl gefertigt, was sowohl Langlebigkeit als auch Robustheit garantiert. Sie ist eine ideale Lösung für Radfahrende, die häufig mit einem Anhänger unterwegs sind und Wert auf eine zuverlässige Verbindung legen. - Spezialkupplung für Rohloff-Ausfallenden mit 30-38 mm Schraubenabstand - Tragfähigkeit von bis zu 80 kg - Einfache Montage mit mitgelieferten NIRO-Schrauben und Nord-Lock-Scheiben - Hergestellt aus einer robusten Kombination von Kunststoff und Stahl.68,30 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wissenschaft & TechnikWissenschaft & Technik , Die illustrierte Weltgeschichte. Mit über 2000 Fotografien, Illustrationen, Grafiken, Zeittafeln und einem Vorwort von Prof. Dr. Wolfgang M. Heckl , Gabel-Reparatursätze > Vorderradaufhängung & Teile , Erscheinungsjahr: 20220830, Produktform: Leinen, Beilage: Cover mit Folienveredlung, Redaktion: Hart-Davis, Adam, Übersetzung: Matthiesen, Stephan~Kamphuis, Andrea~Kliche, Martin, Seitenzahl/Blattzahl: 520, Abbildungen: Über 2000 farbige Fotos und Illustrationen, Keyword: Albert Einstein; Allgemeinbildung; Allgemeinwissen; Astronomie; Atom; Aufklärung; Bildband; Bildung; Biologie; Buchdruck; Chemie, Physik; Deutsches Museum; Digitalisierung; Einstein; Experiment; Geburtstagsgeschenk; Genetik; Geowissenschaften; Geschenk; Informationszeitalter; Internet; Lernen; MINT-Fächer; Mathematik; Medizin; Nachschlagewerk; Nanotechnologie; Naturwissenschaft; Neugier; Radioaktivität; Renaissance; Röntgen; Stephen Hawking; Stringtheorie; Technik; Technik Geschenk; Technikbuch für Erwachsene; Technikgeschichte; Wisschschaft und Technik; Wissen; Wissenschaft; Wissenschaftsbuch; Wissenschaftsgeschichte; Wolfgang M. Heckl; industrielle Revolution; vernetzte Welt, Fachschema: Wissenschaftsgeschichte (Naturwissenschaften)~Wissenschaftsphilosophie~Soziologie / Wissenschaftssoziologie~Wissenschaftssoziologie~Technologie, Fachkategorie: Geschichte der Naturwissenschaften~Technikgeschichte, Warengruppe: HC/Naturwissenschaften/Technik allg., Fachkategorie: Nachschlagewerke, Thema: Verstehen, Text Sprache: ger, Originalsprache: eng, Seitenanzahl: 520, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Dorling Kindersley Verlag, Verlag: Dorling Kindersley Verlag, Verlag: Dorling Kindersley Verlag, Verlag: Dorling Kindersley Verlag GmbH, Länge: 307, Breite: 258, Höhe: 38, Gewicht: 2696, Produktform: Gebunden, Genre: Mathematik/Naturwissenschaften/Technik/Medizin, Genre: Mathematik/Naturwissenschaften/Technik/Medizin, Vorgänger: 2619153, Vorgänger EAN: 9783831035380 9783831026401, Herkunftsland: LETTLAND (LV), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Kennzeichnung von Titeln mit einer Relevanz > 30, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0060, Tendenz: +1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel, WolkenId: 178502449,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wie kann ich mit Python und BeautifulSoup einen Webcrawler für Websites erstellen?
Um einen Webcrawler mit Python und BeautifulSoup zu erstellen, musst du zunächst die BeautifulSoup-Bibliothek installieren. Dann kannst du eine HTTP-Anfrage an die gewünschte Website senden und den HTML-Code der Seite mit BeautifulSoup analysieren. Du kannst dann bestimmte Elemente oder Informationen aus dem HTML-Code extrahieren und weiterverarbeiten. **
-
Welche Faktoren beeinflussen die Geschwindigkeit, mit der Webcrawler eine Website durchsuchen können?
Die Geschwindigkeit, mit der Webcrawler eine Website durchsuchen können, wird von der Serverleistung der Website, der Größe der Website und der Anzahl der Links auf der Website beeinflusst. Außerdem spielen die Netzwerkgeschwindigkeit und die Einstellungen des Webcrawlers eine Rolle bei der Durchsuchungsgeschwindigkeit. Eine gut optimierte Website mit schnellem Server und wenigen Links kann die Geschwindigkeit der Webcrawler erhöhen. **
-
Wie funktionieren Webcrawler und welche Rolle spielen sie bei der Indexierung von Webinhalten?
Webcrawler sind Programme, die automatisch das Internet durchsuchen und Webseiten indexieren. Sie folgen Links von einer Seite zur nächsten, um relevante Informationen zu sammeln. Dadurch helfen sie Suchmaschinen, Webinhalte zu finden und zu organisieren, um sie den Nutzern bei Suchanfragen präsentieren zu können. **
-
Wie funktionieren Webcrawler und was ist ihre Rolle bei der Indexierung von Websites?
Webcrawler sind Programme, die automatisch das Internet durchsuchen, indem sie Links auf Websites verfolgen und deren Inhalte analysieren. Sie sammeln Informationen über Webseiten, wie Texte, Bilder und Links, um sie in Suchmaschinenindexen zu speichern. Dadurch ermöglichen sie Suchmaschinen, relevante Suchergebnisse für Benutzer bereitzustellen. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.